Cours après-midi — Kubernetes Développeur
Le réseau Kubernetes
Le modèle réseau de Kubernetes pour les communications internes
- Chaque Pod a sa propre IP, routable depuis n'importe quel autre Pod du cluster — pas de NAT entre Pods.
- Les Pods d'un même Service sont regroupés derrière une IP stable (le Service).
- Le DNS interne (CoreDNS) résout automatiquement les noms de Service en IP.
Ce qu'un Pod peut joindre, et comment :
| Cible | Adresse | Exemple |
|---|---|---|
| Un autre Pod (même namespace) | IP du Pod directement (rarement utilisé — IP instable) | 10.42.0.15:8080 |
| Un Service (même namespace) | nom court | mon-service:8080 |
| Un Service (autre namespace) | <service>.<namespace> | mon-service.mon-namespace:8080 |
| Un Service (forme complète) | <service>.<namespace>.svc.cluster.local | utile pour du debug ou une config explicite |
| L'API Kubernetes | Service spécial kubernetes dans default | kubernetes.default.svc.cluster.local |
# Depuis un pod, tester la résolution DNS
kubectl exec -it mon-pod -- getent ahosts mon-service.mon-namespace
namespace: mon-namespace              namespace: autre-namespace
┌─────────────────────────┐           ┌─────────────────────────┐
│  Pod A ──► mon-service   │           │  Service: autre-service  │
│            (nom court)   │           │                           │
│                          │──────────►│  mon-service.mon-namespace│
│                          │  (forme longue depuis l'extérieur)    │
└─────────────────────────┘           └─────────────────────────┘
À retenir : un Pod ne connaît jamais l'IP réelle des autres Pods qu'il contacte via un Service — il passe toujours par le nom DNS du Service, qui reste stable même quand les Pods derrière changent.
📖 Documentation officielle — DNS for Services and Pods
Ingress — le reverse proxy HTTP mutualisé
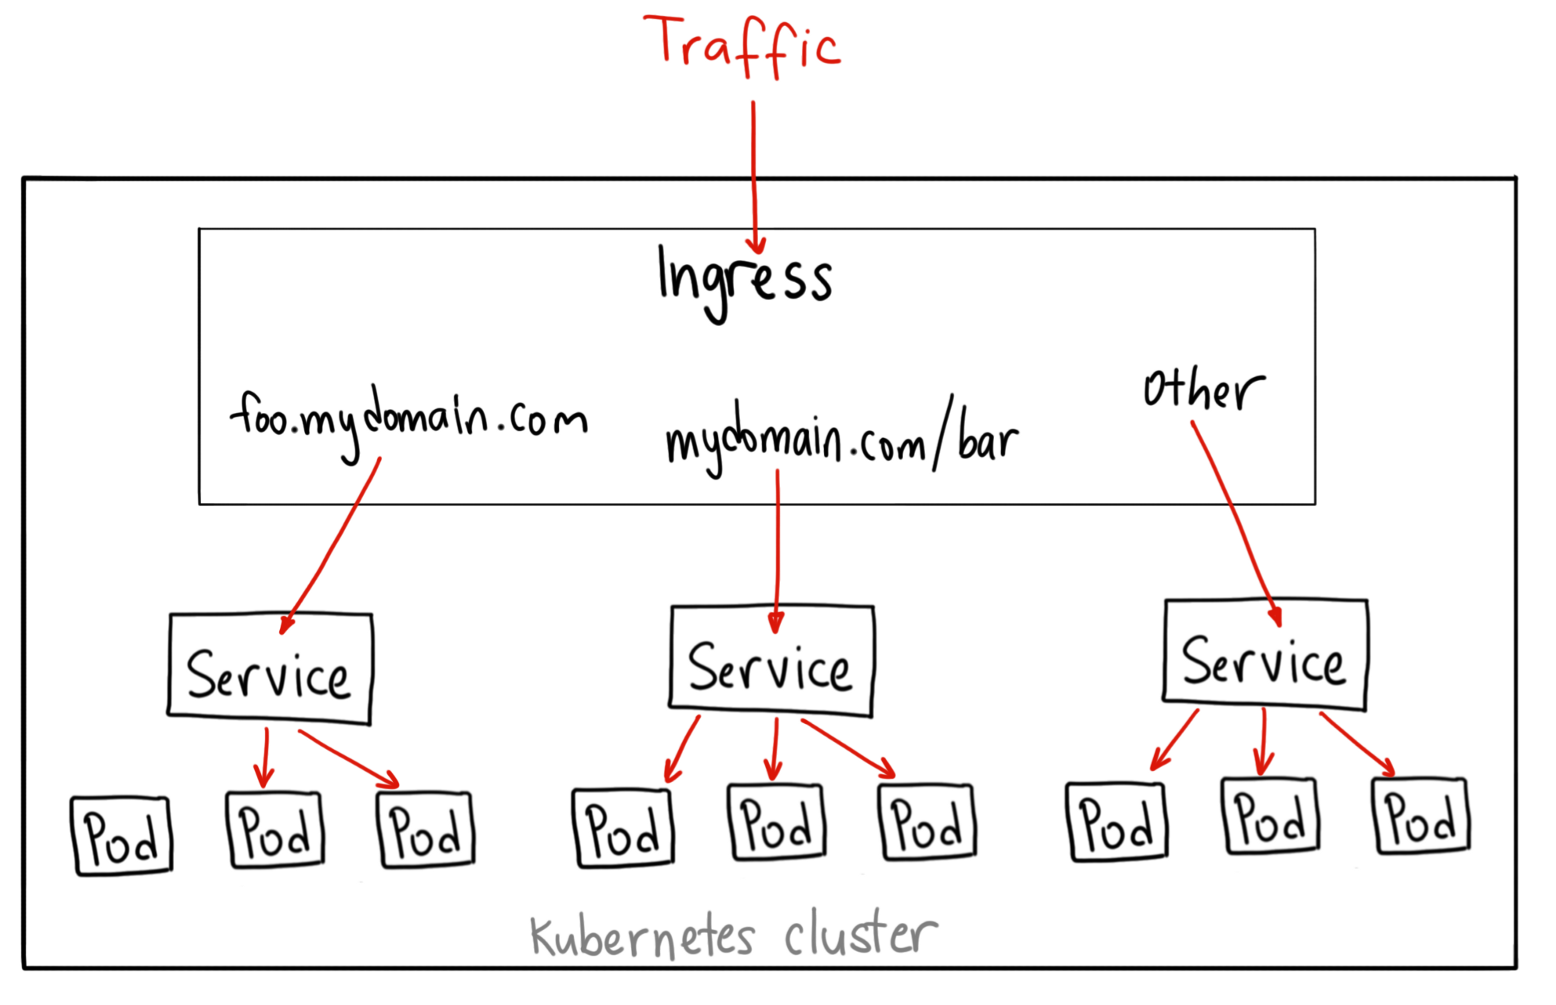
Un Ingress est un objet pour gérer dynamiquement le reverse proxy HTTP/HTTPS dans Kubernetes .
Un seul Ingress Controller reçoit tout le trafic entrant et route vers les bons Services selon des règles :
- Virtual hosting (
api.monapp.com→ service A,app.monapp.com→ service B) - Routage par chemin (
/api→ service A,/static→ service B) - Terminaison TLS mutualisée (un seul certificat, plusieurs apps)
Pour utiliser des Ingresses, il faut d'abord installer un Ingress Controller :
- Un déploiement conteneurisé d'un reverse proxy (nginx, Traefik, etc.) intégré avec l'API Kubernetes
- Il doit lui-même être exposé (ports 80 et 443), généralement via un Service LoadBalancer
- k3s est livré avec Traefik configuré par défaut
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: my-app-ingress
  namespace: mynamespace
  annotations:
    nginx.ingress.kubernetes.io/rewrite-target: /
spec:
  ingressClassName: traefik
  rules:
  - host: mon-app.example.com
    http:
      paths:
      - path: /
        pathType: Prefix
        backend:
          service:
            name: my-app-service
            port:
              number: 80
La limite de l'Ingress : ses fonctionnalités avancées (canary, auth, rate limiting) passent par des annotations spécifiques à chaque controller .
Un manifeste nginx ne fonctionne pas tel quel sur Traefik .
Ce couplage est la raison pour laquelle la communauté a conçu la Gateway API.
Ingress avec TLS (cert-manager)
cert-manager est un opérateur Kubernetes capable de générer automatiquement des certificats TLS/HTTPS pour vos Ingresses (Let's Encrypt).
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: mon-app
  annotations:
    kubernetes.io/ingress.class: "nginx"
    cert-manager.io/issuer: "letsencrypt-prod"
spec:
  tls:
  - hosts:
    - mon-app.example.com
    secretName: mon-app-tls
  rules:
  - host: mon-app.example.com
    http:
      paths:
      - path: /
        pathType: Prefix
        backend:
          service:
            name: mon-app-service
            port:
              number: 80
Gateway API — le successeur standardisé
La Gateway API est la nouvelle norme CNCF qui remplace progressivement l'Ingress .
Elle sépare les responsabilités en trois objets distincts :
| Objet | Rôle | Qui le gère |
|---|---|---|
GatewayClass | Définit le type de gateway (nginx, Traefik, Cilium…) | Admin cluster |
Gateway | Instance du point d'entrée, ports, TLS | Admin réseau |
HTTPRoute | Règles de routage vers les Services | Développeur |
Cette répartition (
Gateway= admin réseau,HTTPRoute= dev) est le modèle prévu par le design, pas une contrainte technique stricte : rien n'empêche un développeur de créer sa propreGatewaysur un petit cluster. Mais le cas d'usage principal de la Gateway API est justement le partage d'une infrastructure réseau entre plusieurs équipes : une seuleGateway(un seul load balancer, une seule IP) peut accepter desHTTPRoutevenant de plusieurs namespaces différents — chaque équipe applicative gère ses propres règles de routage sans avoir besoin de créer ou toucher à l'infrastructure réseau elle-même.Par défaut, une
Gatewayn'accepte que lesHTTPRoutede son propre namespace — c'est une protection de départ, pas une limite technique. Le champallowedRoutespermet à l'admin réseau d'autoriser explicitement d'autres namespaces (ou tous) à y attacher leurs règles. Ce n'est donc jamais "un proxy par namespace" : c'est un proxy partagé, avec un contrôle explicite de qui peut s'y raccorder.
Cette séparation permet à une équipe dev de modifier ses règles de routage sans toucher à la configuration réseau du cluster, et vice-versa .
Les fonctionnalités avancées (canary, header matching, mirroring) sont standardisées — un manifeste HTTPRoute fonctionne sur n'importe quel controller compatible.
Le modèle de ressources, en un schéma :
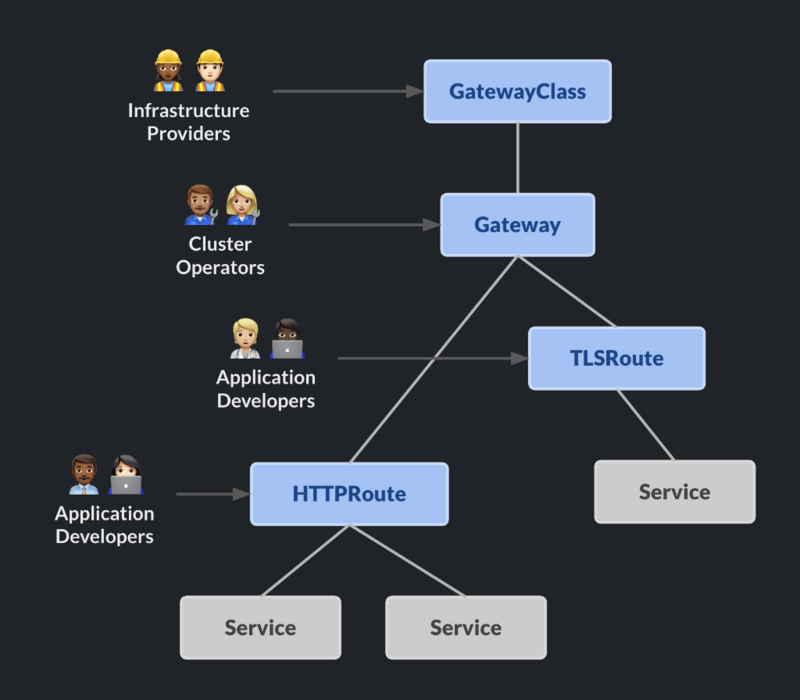 (Schéma officiel Gateway API : GatewayClass → Gateway → Route)
Les trois manifestes, en pratique : chaque objet est déclaré séparément et référence le précédent — c'est cette chaîne qui matérialise la séparation des rôles vue plus haut.
# 1. gatewayclass.yaml — déclaré par l'admin cluster (une fois, pour tout le cluster)
apiVersion: gateway.networking.k8s.io/v1
kind: GatewayClass
metadata:
  name: traefik
spec:
  controllerName: traefik.io/gateway-controller
# 2. gateway.yaml — déclaré par l'admin réseau (le point d'entrée réseau)
apiVersion: gateway.networking.k8s.io/v1
kind: Gateway
metadata:
  name: mon-gateway
  namespace: infra
spec:
  gatewayClassName: traefik   # référence le GatewayClass ci-dessus
  listeners:
  - name: http
    protocol: HTTP
    port: 80
    allowedRoutes:
      namespaces:
        from: All   # autorise les HTTPRoute de tous les namespaces
# 3. httproute.yaml — déclaré par le développeur (dans le namespace de son app)
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: mon-app-route
  namespace: mon-app
spec:
  parentRefs:
  - name: mon-gateway        # référence la Gateway ci-dessus
    namespace: infra
  hostnames:
  - "mon-app.example.com"
  rules:
  - backendRefs:
    - name: mon-app-service
      port: 8080
Implémentations installables aujourd'hui : ce cours utilise déjà Traefik (fourni par défaut avec k3s) pour l'Ingress — c'est aussi une implémentation Gateway API à part entière, pas un outil différent à installer :
# Installer les CRDs Gateway API (k3s ne les fournit pas par défaut)
kubectl apply -f https://github.com/kubernetes-sigs/gateway-api/releases/download/v1.0.0/standard-install.yaml

# Activer le provider Gateway API dans Traefik (via sa configuration Helm/statique)
# providers.kubernetesGateway: {}
Autres implémentations courantes (à connaître de nom) : Istio (propose une installation minimale conforme Gateway API sans installer tout le service mesh), Envoy Gateway (projet dédié, quickstart simple).
Au-delà du HTTP : la Gateway API n'est pas limitée au routage HTTP. Selon le controller installé, elle peut aussi router du TCP/UDP brut ou du TLS (TCPRoute, UDPRoute, TLSRoute — kinds "experimental", pas encore stables partout). Un seul Gateway peut donc exposer plusieurs types de trafic sur des ports différents.
Répartition du trafic (poids) : un HTTPRoute peut répartir le trafic entre plusieurs Services via backendRefs[].weight — utile pour du canary/blue-green sans outil externe :
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: mon-app-route
spec:
  parentRefs:
  - name: mon-gateway
  rules:
  - backendRefs:
    - name: mon-app-v1
      port: 8080
      weight: 90   # 90% du trafic
    - name: mon-app-v2
      port: 8080
      weight: 10   # 10% du trafic (canary)
Avantages vs. Ingress :
- Standard portable : un même
HTTPRoutefonctionne sur n'importe quel controller compatible (pas d'annotations propriétaires par vendor). - Modèle de rôles natif (
GatewayClass/Gatewaycôté admin,HTTPRoutecôté dev) — pas besoin de RBAC custom pour séparer admin réseau et développeurs. - Fonctionnalités avancées (poids, header matching, mirroring) standardisées, pas cachées derrière des annotations spécifiques à chaque Ingress Controller.
Inconvénients :
- Plus récent, moins universellement supporté que l'Ingress (tous les clusters n'ont pas de
GatewayClassinstallée par défaut — k3s/Traefik expose l'Ingress nativement, pas la Gateway API). - Trois objets à comprendre au lieu d'un seul — courbe d'apprentissage plus longue pour un cas d'usage simple.
📖 Documentation officielle — Gateway API · Spec complète (types de Route)
Au-delà de l'exposition : les API Managers
Exposer un Service vers l'extérieur ne résout pas tout .
En production, on a souvent besoin de fonctionnalités que ni l'Ingress ni la Gateway API ne couvrent nativement :
- Authentification et autorisation (OAuth2, API keys, JWT)
- Rate limiting par client ou par plan tarifaire
- Observabilité : métriques par endpoint, par consommateur
- Versionnement d'API et gestion du cycle de vie
- Transformation de requêtes/réponses
C'est le rôle des API Managers (ou API Gateways applicatifs) : Kong, Gravitee, Apigee, AWS API Gateway .
Ils s'intercalent entre le point d'entrée réseau et les services, et ajoutent une couche de gouvernance.
Internet → Gateway API / Ingress → API Manager → Services Kubernetes
                                        │
                             auth, rate limit, métriques, versioning
Pour ce cours, on travaille avec l'Ingress (supporté nativement par k3s/Traefik) .
La Gateway API et les API Managers sont des étapes naturelles dès qu'on expose des APIs à des tiers ou qu'on a plusieurs équipes consommatrices.
NetworkPolicy : firewalls dans le cluster
Par défaut, tous les pods peuvent communiquer entre eux — il n'y a aucune isolation réseau.
Les NetworkPolicies permettent de restreindre les communications entre pods, comme des règles de firewall.
Points clés :
- Un pod non ciblé par une NetworkPolicy accepte tout le trafic
- Dès qu'une NetworkPolicy cible un pod, ce pod rejette tout trafic non explicitement autorisé
- Nécessite un CNI qui supporte les NetworkPolicies (Calico, Cilium, Weave — pas Flannel seul)
Exemple : bloquer tout trafic entrant sauf depuis les pods avec role=allowed
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: deny-all-except-allowed
  namespace: mynamespace
spec:
  podSelector:
    matchLabels:
      app: web
  policyTypes:
  - Ingress
  ingress:
  - from:
    - podSelector:
        matchLabels:
          role: allowed
Les Service Mesh
Un Service Mesh ajoute une couche réseau transverse entre vos Services, sans toucher au code applicatif — sécurité, observabilité et routage deviennent une responsabilité d'infrastructure plutôt qu'une bibliothèque à intégrer dans chaque service.
Ce qu'il apporte concrètement :
- mTLS : chaque appel entre Services peut être chiffré et authentifié dans les deux sens (les deux parties prouvent leur identité), sans que le code applicatif gère le moindre certificat. Pas automatique par défaut : Istio démarre en mode
PERMISSIVE(accepte le trafic chiffré ET en clair, pour permettre une migration progressive) — il faut déclarer une politique pour l'imposer :
apiVersion: security.istio.io/v1
kind: PeerAuthentication
metadata:
  name: namespace-mtls-strict
  namespace: mon-namespace
spec:
  mtls:
    mode: STRICT   # refuse tout trafic non chiffré dans ce namespace
- Fonctions de routage avancées : retry automatique, circuit breaking, canary/blue-green par pourcentage de trafic, timeouts — configurables sans redéploiement de l'application.
- Observabilité : métriques, traces et logs uniformes pour tout le trafic inter-services, même si les services sont écrits dans des langages différents.
Comment ça s'installe : sidecar vs. ambient mode
Mode sidecar (historique)              Mode ambient (recent)
┌─────────────────────┐                ┌─────────────────────┐
│ Node                │                │ Node                │
│ ┌─────┐  ┌─────┐    │                │ ┌─────┐  ┌─────┐    │
│ │ Pod │  │ Pod │    │                │ │ Pod │  │ Pod │    │
│ │ app │  │ app │    │                │ │ app │  │ app │    │
│ │proxy│  │proxy│    │  <- 1 proxy    │ └─────┘  └─────┘    │
│ └─────┘  └─────┘    │     par Pod    │        │       │    │
│                     │                │   ┌────┴───────┴┐   │
│                     │                │   │ ztunnel     │ <- 1 proxy
│                     │                │   │ (par nœud)  │    par nœud
└─────────────────────┘                └─────────────────────┘
- Sidecar (modèle historique) : un proxy (Envoy) est injecté dans chaque Pod, à côté du conteneur applicatif — un sidecar est un conteneur secondaire qui tourne aux côtés du conteneur principal pour lui ajouter une responsabilité transverse (ici : réseau, chiffrement, routage) sans toucher à son code. Chaque Pod paie un coût mémoire/CPU pour son proxy.
- Ambient mode (approche récente, ex: Istio Ambient) : plus de proxy par Pod — l'interception du trafic se fait au niveau du nœud (un composant partagé, ex:
ztunnelchez Istio). Moins de surcoût par Pod, modèle opérationnel plus simple, au prix d'un peu moins de flexibilité par Pod.
L'identité des services (qui peut parler à qui) repose sur un standard nommé SPIFFE (implémenté par SPIRE) — chaque Pod reçoit une identité cryptographique vérifiable, indépendante de son IP.
Outils courants : Istio, Linkerd, Cilium (mode mesh).
📖 Documentation officielle Istio — Architecture · Sécurité et mTLS · Ambient mode
GitOps avec ArgoCD
Infrastructure as Code et YAML comme source de vérité
Pourquoi ne pas appliquer les manifestes YAML à la main ?
- Impossible de savoir quelle version a été appliquée en dernier — ni par qui, ni pourquoi
- Aucun moyen simple de revenir en arrière sur un changement en production
- L'état réel du cluster diverge progressivement des fichiers dans le repo
L'approche Infrastructure as Code répond à ça : tout ce qui tourne dans le cluster est décrit dans des fichiers YAML versionnés dans Git — pas de commande impérative, pas de modification manuelle en prod. L'historique Git est l'historique du cluster.
Le GitOps va un cran plus loin : Git n'est pas seulement un endroit où stocker des fichiers, c'est la seule source de vérité. L'état déclaré dans Git est l'état réel du cluster. Tout changement passe par un commit — auditable, réversible, soumis à review via une Pull Request.
Dev         → commit YAML dans Git
Git         → source de vérité unique
ArgoCD      → surveille Git, réconcilie le cluster en continu
Cluster     → reflète exactement ce qui est dans Git
Kustomize et Helm dans un workflow GitOps
ArgoCD supporte nativement Kustomize et Helm — il sait les appliquer sans étape intermédiaire.
Avec Kustomize : le repo Git contient les bases et les overlays. ArgoCD pointe vers l'overlay de l'environnement cible.
source:
  repoURL: https://github.com/monorg/mon-repo.git
  targetRevision: main
  path: overlays/prod          # ArgoCD applique kubectl kustomize overlays/prod
Avec Helm : ArgoCD peut référencer un chart depuis un repo Helm ou depuis le dépôt Git directement, avec les valeurs de l'environnement.
source:
  repoURL: https://github.com/monorg/mon-repo.git
  targetRevision: main
  path: charts/mon-app
  helm:
    valueFiles:
    - values-prod.yaml         # valeurs spécifiques à la prod
Dans les deux cas, la promotion entre environnements (dev → staging → prod) se fait en mettant à jour le fichier de valeurs ou l'overlay correspondant dans Git — pas en exécutant une commande.
ArgoCD : l'opérateur de réconciliation
ArgoCD surveille un dépôt Git et rapproche en continu l'état du cluster avec ce qui y est déclaré. Il ajoute un type d'objet Application :
apiVersion: argoproj.io/v1alpha1
kind: Application
metadata:
  name: mon-app
  namespace: argocd
spec:
  destination:
    namespace: mon-app
    server: https://kubernetes.default.svc
  project: default
  source:
    repoURL: https://github.com/monorg/mon-repo.git
    targetRevision: main
    path: k8s/
Si un opérateur modifie manuellement une ressource dans le cluster, ArgoCD détecte la dérive et la signale (ou la corrige automatiquement selon la configuration).
Drift : quand le cluster diverge de Git
Le drift est l'écart entre l'état déclaré dans Git et l'état réel du cluster. Il arrive quand quelqu'un applique un manifeste à la main, modifie une ressource avec kubectl edit, ou qu'un contrôleur tiers mute une ressource sans passer par Git.
ArgoCD expose un statut de synchronisation sur chaque Application : Synced (cluster = Git) ou OutOfSync (dérive détectée). Par défaut il signale sans corriger — c'est le comportement recommandé pour commencer, car une correction automatique agressive peut surprendre une équipe qui n'a pas encore le réflexe GitOps.
Pour activer la correction automatique, on configure syncPolicy.automated avec selfHeal: true :
spec:
  syncPolicy:
    automated:
      selfHeal: true    # ArgoCD écrase toute modification manuelle
      prune: true       # supprime aussi les ressources absentes de Git
La bonne pratique : activer selfHeal en prod une fois que l'équipe est disciplinée sur les workflows Git, et garder un mode manual en dev pour permettre l'expérimentation. Dans tous les cas, bannir kubectl edit sur des ressources gérées par ArgoCD — toute modification manuelle sera soit écrasée, soit source de confusion.
Avancé : GitOps sans accès direct à Git (OCI Artifacts)
Dans un workflow GitOps classique, ArgoCD doit pouvoir accéder au dépôt Git en temps réel — ce qui pose deux problèmes en production :
- Sécurité : le cluster a besoin d'un accès réseau et d'un token vers le dépôt Git (souvent hébergé sur GitHub, GitLab…)
- Performance : sur un grand cluster avec de nombreuses
Application, ArgoCD poll Git fréquemment — potentiellement soumis au rate limiting
Une approche alternative, parfois appelée "Gitless GitOps", consiste à publier la configuration rendue (les manifestes finaux, après Kustomize ou Helm) comme un artefact OCI dans un registry de conteneurs, et à faire pointer ArgoCD sur ce registry plutôt que sur Git directement.
CI pipeline   → kustomize build overlays/prod | argocd-image-updater push
              → pousse l'artefact OCI dans registry.example.com/config/mon-app:v1.2.3

ArgoCD        → source: oci://registry.example.com/config/mon-app:v1.2.3
              → plus besoin d'accès à Git depuis le cluster
source:
  repoURL: oci://registry.example.com/config/mon-app
  targetRevision: v1.2.3       # tag OCI = version de la config
  path: .
Avantages :
- Le cluster n'a accès qu'au registry (déjà nécessaire pour les images) — pas à Git
- Les manifestes publiés sont immuables et reproductibles (tag de version explicite)
- Flux plus simple à sécuriser en réseau isolé ou air-gapped
Inconvénient : la CI doit publier l'artefact à chaque changement — une étape supplémentaire dans le pipeline.
Flux CD (l'alternative à ArgoCD maintenue par la CNCF) supporte nativement les sources OCI depuis la v0.32.
Autoscaling : HorizontalPodAutoscaler (HPA)
Le HPA permet d'ajuster automatiquement le nombre de replicas d'un Deployment en fonction de métriques (CPU, RAM, métriques custom).
Il s'appuie sur le Metrics Server qui collecte en temps réel l'utilisation CPU/RAM des pods.
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: mon-app-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: mon-app
  minReplicas: 2
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
Si l'utilisation CPU moyenne dépasse 70%, le HPA augmente le nombre de replicas jusqu'à 10.
Prérequis : les pods doivent avoir des requests CPU définies pour que le HPA puisse calculer le ratio.
Scénario concret : votre Deployment a minReplicas: 2, maxReplicas: 10, seuil CPU 70%.
- Le trafic augmente, l'utilisation CPU moyenne des pods passe à 90%.
- Toutes les 15 secondes (intervalle de vérification par défaut du controller HPA), le HPA recalcule le nombre de replicas souhaité :
replicas_actuels × (utilisation_actuelle / utilisation_cible). Ici :2 × (90/70) ≈ 3. - Le HPA met à jour le Deployment à 3 replicas. Le nouveau pod démarre, l'utilisation CPU redescend progressivement vers 70%.
- Si le trafic redescend ensuite, le HPA scale down — mais plus lentement qu'il ne scale up : un délai de stabilisation par défaut de 5 minutes (
stabilizationWindowSeconds: 300) évite qu'un pic de trafic court ne déclenche un aller-retour scale up/scale down permanent ("flapping").
CPU
90% ┤     ╭──╮                                  scale up immédiat
    │    ╱    ╲                                 (check toutes les 15s)
70% ┤───╱──────╲───────────────────────────────
    │  ╱         ╲___________________________   scale down différé
    │ ╱                                      ╲  (attend 5 min de stabilité)
    └──────────────────────────────────────────── temps
      t0   t0+15s        pic redescendu    t0+15s+5min
      pic   scale up        à t1              scale down effectif
      CPU   2→3 pods                          3→2 pods
kubectl get hpa mon-app-hpa -w   # observer les décisions du HPA en temps réel
kubectl describe hpa mon-app-hpa # voir les événements de scaling et leur raison
Scale up rapide, scale down prudent : c'est un choix de design volontaire — mieux vaut avoir temporairement un peu trop de pods (coût) que pas assez (indisponibilité).
📖 Documentation officielle — Horizontal Pod Autoscaling
HPA/VPA et le risque de "drift" GitOps
Le HPA et le VPA modifient en permanence l'état réel du cluster (replicas, requests/limits) sans jamais passer par Git. Si votre manifeste déclare replicas: 2 et que le HPA a scalé à 9, ces deux sources de vérité divergent — exactement la définition d'un drift GitOps.
Sans aucun outil GitOps, le problème existe déjà. kubectl apply compare trois versions (fichier, dernière config appliquée, état réel du cluster) : si le fichier n'a pas changé depuis le dernier apply, il réimpose sa valeur, même si le HPA l'a modifiée entre-temps. Résultat documenté officiellement :
« Quand un HPA est actif, il est recommandé de retirer
spec.replicasdu manifeste du Deployment et/ou StatefulSet. Si ce n'est pas fait, chaquekubectl apply -f deployment.yamlréimposera la valeur despec.replicasdu fichier — ce qui peut être indésirable et provoquer un comportement de "thrashing" (oscillation) quand un HPA est actif. »
La solution : ne pas déclarer dans Git ce que le HPA/VPA doit piloter.
# À éviter une fois le HPA actif sur ce Deployment :
spec:
  replicas: 2   # sera réimposé à chaque apply, en conflit avec le HPA

# Recommandé : ne pas déclarer replicas du tout, laisser le HPA seul décider
spec:
  # (pas de champ replicas ici)
⚠️ Retirer
replicasd'un Deployment déjà scalé peut provoquer une dégradation ponctuelle : la valeur par défaut du champ est1, donc au moment de l'apply sansreplicas, Kubernetes peut temporairement redescendre vers 1 pod avant que le HPA ne recalcule et rescale.
Avec un outil GitOps (ArgoCD, etc.), le même problème existe, en pire : selfHeal: true réappliquerait Git en continu, pas seulement au prochain kubectl apply manuel — un vrai combat permanent entre ArgoCD et le HPA. La solution est équivalente mais explicite : dire à ArgoCD quels champs ne lui appartiennent pas.
apiVersion: argoproj.io/v1alpha1
kind: Application
spec:
  ignoreDifferences:
  - group: apps
    kind: Deployment
    jsonPointers:
    - /spec/replicas          # laisse le HPA piloter ce champ
  # ou, plus large : ignorer tout ce qui appartient à un contrôleur donné
  # managedFieldsManagers:
  # - horizontal-pod-autoscaler
Le principe est le même sans ou avec GitOps : Git (ou le fichier YAML) ne doit déclarer que ce qu'il est censé contrôler. Un champ piloté par un autre contrôleur (HPA, VPA) doit être explicitement exclu de la comparaison — retiré du manifeste en
kubectl applysimple, exclu viaignoreDifferencesen GitOps.
📖 Documentation officielle — Migrating Deployments and StatefulSets to horizontal autoscaling · ArgoCD — Diffing Customization
Pourquoi KEDA plutôt que le HPA seul ? Le HPA natif ne sait scaler que sur des métriques de ressources (CPU/RAM) ou des métriques custom déjà exposées à Kubernetes. Pour scaler sur la profondeur d'une file Kafka (nombre de messages en attente), il n'a pas de mécanisme natif. KEDA (CNCF, Microsoft/Red Hat) comble ce manque : il traduit des métriques externes (lag Kafka, longueur de queue SQS/RabbitMQ, etc.) en métriques que le HPA sait consommer — et il sait aussi scaler jusqu'à zéro replica, ce que le HPA seul ne fait pas (il lui faut au moins un pod pour mesurer quelque chose).
Fonctionnement : on déclare un ScaledObject qui pointe vers le Deployment à scaler et vers la source de métrique (ici, le lag de consommateur Kafka) :
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: kafka-consumer-scaler
spec:
  scaleTargetRef:
    name: mon-consumer
  minReplicaCount: 0
  maxReplicaCount: 20
  triggers:
  - type: kafka
    metadata:
      bootstrapServers: kafka.mynamespace:9092
      consumerGroup: mon-groupe
      topic: mes-evenements
      lagThreshold: "50"   # 1 replica de plus toutes les 50 messages de retard
KEDA crée et pilote automatiquement un HPA standard derrière ce ScaledObject — vous n'interagissez jamais avec le HPA directement.
Kafka (lag consumer)
      │
      ▼
┌───────────────┐        ┌──────────┐        ┌────────────┐
│ ScaledObject  │──────► │ KEDA     │──────► │ HPA (auto- │──────► scale le
│ (vous écrivez)│        │ operator │        │ généré)    │        Deployment
└───────────────┘        └──────────┘        └────────────┘
     ▲
     │ traduit en métrique standard
     │ consommable par le HPA
Kafka n'est qu'un exemple parmi ~60 scalers fournis par KEDA (RabbitMQ, SQS, Prometheus, cron, etc.). Un service qui n'utilise pas de broker de messages peut aussi exposer sa propre métrique métier (profondeur de file interne, nombre de tâches en attente...) via les scalers metrics-api ou external — KEDA n'impose donc jamais un transport de messages particulier, il consomme n'importe quelle métrique qu'on lui fournit.
Avantages : scaling piloté par la vraie charge métier (retard de traitement) plutôt qu'un proxy indirect (CPU) ; lecture plus explicite du manifeste (lagThreshold: 50 est plus parlant que "70% CPU" pour une queue) ; scale-to-zero entre les pics.
📖 Documentation officielle KEDA — Concepts · Scaler Kafka
Le problème que VPA résout : des requests fixées "pour être large" gaspillent des ressources réservées mais jamais utilisées — un ratio CPU réservé/CPU réellement utilisé trop élevé, qui bloque le scheduling d'autres pods pour rien.
Le HPA ajuste le nombre de pods. Le VPA (Vertical Pod Autoscaler) ajuste la taille (requests/limits) de chaque pod, en observant sa consommation réelle dans le temps. Contrairement au HPA, VPA n'est pas un composant natif de Kubernetes — c'est un add-on séparé (projet kubernetes/autoscaler), à installer et opérer soi-même.
Trois composants distincts, pas une boîte noire :
- Recommender : analyse l'usage réel et calcule des recommandations de
requests/limits. - Updater : applique ces recommandations aux pods existants — par redimensionnement à chaud si possible, sinon par éviction/recréation selon le mode choisi (voir ci-dessous).
- Admission controller webhook : applique les recommandations aux nouveaux pods au moment de leur création.
apiVersion: autoscaling.k8s.io/v1
kind: VerticalPodAutoscaler
metadata:
  name: mon-app-vpa
spec:
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: mon-app
  updatePolicy:
    updateMode: "InPlace"   # ou "Off" (recommandations seules), "Recreate", "InPlaceOrRecreate"
Modes d'application :
Off: VPA calcule des recommandations mais ne touche à rien — utile pour observer avant d'automatiser.Initial: applique la recommandation uniquement à la création du pod (au premier déploiement) — jamais sur un pod déjà en cours d'exécution. Un compromis entre "rien" (Off) et "ça bouge en permanence".Recreate: VPA recrée le pod pour appliquer un nouveau dimensionnement — le pod redémarre, peut changer de nœud, une éviction n'est pas garantie de réussir immédiatement.Auto: déprécié, équivalent àRecreate— ne pas utiliser dans une config écrite aujourd'hui.InPlaceOrRecreate/InPlace(modes à privilégier aujourd'hui) : s'appuient sur le redimensionnement à chaud des conteneurs (capacité standard de Kubernetes, sans recréation du pod). Ils diffèrent sur l'échec :InPlaceOrRecreateretente en modeRecreatesi le redimensionnement à chaud échoue ;InPlacene bascule jamais vers une recréation — il laisse le kubelet réessayer plus tard.InPlaceest donc le choix si aucune interruption n'est tolérable.
⚠️ Ces deux modes à chaud nécessitent d'activer des feature gates :
InPlacePodVerticalScalingau niveau du cluster, et un gate spécifiqueInPlacecôté VPA (admission + updater). Ce n'est pas le comportement par défaut d'une installation VPA standard.
⚠️ Ce n'est pas un simple interrupteur à activer. Points de vigilance réels : HPA et VPA sur la même métrique (ex: CPU) ne doivent jamais être combinés — ils entreraient en conflit sur les mêmes décisions ; combiner VPA (mémoire) et HPA (CPU) sur un même Deployment reste possible. VPA n'est pas garanti compatible avec les workloads utilisant des
resourcesau niveau Pod plutôt que conteneur (limitation connue, en cours de résolution). Plusieurs VPA ciblant le même pod produisent un comportement non défini. À tester en modeOffavant toute automatisation en production.
Enjeu de frugalité : un cluster où chaque équipe sur-réserve "pour être tranquille" force l'ajout de nœuds (donc du coût) alors que l'utilisation réelle reste basse — un cas réel typique : 14% d'usage CPU réel sur le cluster, mais 81% réservé. VPA automatise le juste dimensionnement, mais au prix d'une vraie complexité opérationnelle à assumer.
📖 Documentation officielle — Autoscaling Workloads · Limitations connues
Sécurité
Sécurité : scanning d'images
Avant de déployer une image, il faut s'assurer qu'elle ne contient pas de vulnérabilités connues (CVEs).
Trivy est un outil open-source de scanning d'images :
trivy image nginx:latest
Les bonnes pratiques :
- Toujours utiliser des tags explicites (
nginx:1.25.3), jamaislatest - Reconstruire régulièrement vos images pour patcher les CVEs sur l'image de base
- Intégrer le scanning dans la CI/CD — bloquer si trop de failles critiques
- 6 mois est déjà vieux pour une image de conteneur
Les CVE et la course aux mises à jour
Le scanning d'image détecte les CVEs, mais ne les corrige pas. Reconstruire une image régulièrement suppose de savoir quand une nouvelle version d'une dépendance ou d'une image de base est disponible — un suivi manuel intenable à l'échelle d'un projet.
Renovate automatise ce suivi : il scanne votre dépôt (Dockerfiles, manifestes Kubernetes, fichiers de dépendances applicatives) et ouvre automatiquement une Pull Request dès qu'une nouvelle version est disponible.
# Avant (dans un Deployment)
image: mon-app:1.2.0

# Renovate détecte une nouvelle version et ouvre une PR qui change :
image: mon-app:1.3.0
Pour les manifestes Kubernetes, Renovate ne scanne rien par défaut — il faut déclarer explicitement les fichiers à suivre dans sa configuration (
managerFilePatterns). Oublier cette étape est l'erreur la plus fréquente : "j'ai installé Renovate mais rien ne se passe."
Ce que ça change concrètement : au lieu d'un audit manuel périodique, chaque mise à jour disponible devient une PR à review — le patching de CVE devient un flux de travail Git normal (review, CI, merge) plutôt qu'une tâche séparée à ne pas oublier.
Équivalents existants : Dependabot, intégré nativement à GitHub (pas d'installation séparée, juste un fichier dependabot.yml), fait la même chose côté GitHub. Renovate reste plus configurable (regroupement de PRs, planification fine, plus d'écosystèmes couverts) et fonctionne sur GitHub, GitLab, Bitbucket — pas seulement GitHub. En pratique : Dependabot si votre code est déjà 100% sur GitHub et que la configuration par défaut suffit ; Renovate si vous avez besoin de plus de contrôle ou d'un autre hébergeur Git.
📖 Documentation officielle Renovate · Support Kubernetes · Dependabot
Les Policy Agents et les hooks d'adminssion
Ce que fait un Policy Agent : intercepter chaque objet soumis à l'API Kubernetes (via un admission webhook) et décider de l'accepter ou de le rejeter selon des règles déclaratives — avant même que l'objet soit persisté dans etcd. Un Policy Agent peut fonctionner en mode mutation (il modifie l'objet à la volée, ex: injecter une valeur par défaut) ou en mode validation : rejeter purement et simplement ce qui ne respecte pas la politique.
kubectl apply -f pod.yaml
        │
        ▼
┌───────────────┐    mutation     ┌──────────────┐   validation    ┌───────┐
│ kube-apiserver │ ─────────────► │ Policy Agent │ ──────────────► │ etcd  │
│                │  (objet modifié│ (webhook)    │  ALLOW / DENY   │(perst)│
└───────────────┘   si besoin)    └──────────────┘                └───────┘
                                          │
                                     DENY │
                                          ▼
                                   requête rejetée,
                                   pod jamais créé
OPA (Open Policy Agent) est le projet CNCF fondateur de cette approche — un moteur de politique générique, pas spécifique à Kubernetes. OPA Gatekeeper est la couche d'intégration Kubernetes recommandée : elle transforme les politiques en objets Kubernetes natifs (ConstraintTemplate + Constraint).
# ConstraintTemplate : définit la règle (en Rego, le langage de policy d'OPA)
apiVersion: templates.gatekeeper.sh/v1
kind: ConstraintTemplate
metadata:
  name: k8spodsecrequired
spec:
  crd:
    spec:
      names:
        kind: K8sPodSecRequired
  targets:
    - target: admission.k8s.gatekeeper.sh
      rego: |
        package k8spodsec
        violation[{"msg": msg}] {
          volume := input.review.object.spec.volumes[_]
          volume.hostPath
          msg := "les volumes hostPath sont interdits"
        }
---
# Constraint : applique la règle à un périmètre (ici : tous les Pods)
apiVersion: constraints.gatekeeper.sh/v1beta1
kind: K8sPodSecRequired
metadata:
  name: pod-security-required
spec:
  match:
    kinds:
      - apiGroups: [""]
        kinds: ["Pod"]
Ce couple ConstraintTemplate/Constraint rejetterait tout Pod déclarant un volume hostPath — un pattern à éviter, car il lie un Pod à un nœud spécifique et pose des risques de sécurité (accès direct au filesystem du nœud).
Concurrents à connaître de nom : Kyverno (politiques exprimées en YAML pur, sans langage dédié à apprendre — plus simple à prendre en main qu'OPA) et jsPolicy (politiques en JavaScript). Kyverno est aujourd'hui souvent préféré pour sa syntaxe plus proche de Kubernetes ; OPA/Gatekeeper reste répandu en entreprise et plus générique (utilisable hors Kubernetes aussi).
Bonnes pratiques usuelles imposées par ces outils : interdire hostPath, exiger un securityContext (runAsNonRoot: true), interdire les images :latest, imposer des requests/limits.
📖 Documentation officielle — Open Policy Agent & Kubernetes · OPA Gatekeeper
Les modules de sécurité avancée
Un contrôle en amont (au moment du déploiement) ne détecte rien de ce qui se passe une fois le conteneur en cours d'exécution. Falco couvre cet angle mort : il surveille en continu ce qui se passe réellement dans les conteneurs en cours d'exécution, au niveau du kernel (via eBPF), et alerte sur des comportements suspects — même si l'objet déployé au départ était parfaitement conforme.
Ce que Falco détecte typiquement :
- Un shell lancé dans un conteneur qui ne devrait jamais en avoir besoin
- Une écriture dans un fichier sensible (
/etc/shadow, binaires système) - Une élévation de privilèges inattendue à l'intérieur d'un conteneur
- Une connexion réseau sortante vers une IP inhabituelle
# Exemple de règle Falco (extrait) : détecter un shell interactif dans un conteneur
- rule: Terminal shell in container
  desc: Un shell interactif a été lancé dans un conteneur
  condition: >
    spawned_process and container
    and shell_procs and proc.tty != 0
  output: >
    Shell ouvert dans un conteneur (user=%user.name container=%container.name
    shell=%proc.name parent=%proc.pname)
  priority: WARNING
Policy Agent = prévention (bloque avant que ça existe). Falco = détection (alerte pendant que ça se passe). Les deux sont complémentaires, pas substituables l'un à l'autre.
   déploiement                                   durée de vie du pod
        │                                        (potentiellement des jours/mois)
        ▼                                        ────────────────────────────►
┌───────────────┐
│ Policy Agent  │  contrôle ponctuel,
│ (avant)       │  à ce seul instant
└───────────────┘
                    ┌──────────────────────────────────────────────┐
                    │ Falco : surveillance continue (kernel/eBPF)   │
                    │ alerte à tout moment si comportement suspect  │
                    └──────────────────────────────────────────────┘
📖 Documentation officielle Falco